GPT-6.1 Sol kontra Claude Opus 5.5 w codziennej pracy
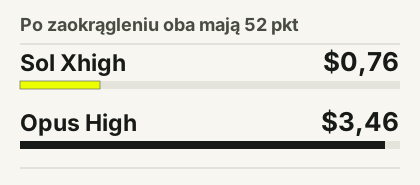
Sol Xhigh kosztuje 0,76 USD za próbę w indeksie. Opus High kosztuje 3,46 USD przy tym samym wyniku po zaokrągleniu. Gdzie warto dopłacić?
GTM Architect & Growth Operator · Insights · 10 listopada 2026 · 4 min czytania
W tym artykule
GPT-6.1 Sol na Xhigh i Claude Opus 5.5 na High mają po zaokrągleniu po 52 punkty w indeksie Artificial Analysis. Próba kosztuje 0,76 USD dla Sola i 3,46 USD dla Opusa. Do powtarzalnych zadań zacząłbym od Sola. Opusa włączyłbym tam, gdzie wynik wymaga zbyt wielu poprawek. Porównanie Artificial Analysis
Tu porównuję GPT-6.1 Sol. Wrześniowy tekst dotyczył GPT-6 Sol i starszej wersji indeksu. Porównanie z września
Koszt według poziomu rozumowania
| Tryb | Punkty Sol | USD Sol | Punkty Opus | USD Opus |
|---|---|---|---|---|
| Medium | 46 | 0,36 USD | 48 | 2,45 USD |
| High | 50 | 0,59 USD | 52 | 3,46 USD |
| Xhigh | 52 | 0,76 USD | 57 | 6,05 USD |
| Max | 55 | 1,27 USD | 59 | 10,04 USD |
Koszt to ważony szacunek API na próbę w indeksie, z domyślnym modelem zastępczym dla Opusa. Nazwy ustawień są takie same, ale dostawcy mogą przeznaczać na nie różną moc obliczeniową. Odczyt z 10 listopada 2026 r. Artificial Analysis Intelligence Index v5.0.1
Domyślne ustawienie obu API to Medium. Opus wyprzedza wtedy Sola o dwa punkty. Na Max przewaga rośnie do czterech punktów, a koszt Opusa jest około 7,9 raza wyższy. Zacząłbym od Sola na High i sprawdził, które nieudane zadania warto skierować do Opusa. API OpenAI · API Claude
Gdzie rozchodzą się wyniki
| Test Artificial Analysis | Sol Xhigh | Opus High |
|---|---|---|
| Terminal-Bench 4.0 | 54,0% | 56,6% |
| FrontierCode 2.0 | 38,5% | 35,9% |
| AutomationBench-AA | 66,6% | 63,2% |
| GDP.pdf | 31,8% | 28,8% |
Opus w tym zestawieniu wypada też lepiej w AA-Briefcase v1.1. Przy dopracowanym briefie z kilku dokumentów dałbym oba wyniki tej samej osobie do oceny. W automatyzacji pierwszy przebieg puściłbym na Solu. W pracy z repozytorium test terminala i test poprawek wskazują różnych zwycięzców. Wybierz zgłoszenie, które przypomina twoją pracę. Wyniki testów cząstkowych
Stawki API powyżej 272 tys. tokenów wejścia
| Parametr API | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Wejście bez cache / mln | 2 USD | 4 USD |
| Odczyt cache / mln | 0,10 USD | 0,20 USD |
| Wyjście / mln | 10 USD | 20 USD |
| Zapis cache / mln, 5 min w Claude i standard w OpenAI | 2,50 USD | 5 USD |
| Okno kontekstu API | 1,05 mln | 1 mln |
| Maks. wyjście | 128 tys. | 128 tys. |
Powyżej 272 tys. tokenów wejścia Sol nalicza za milion 4 USD za wejście bez cache, 0,20 USD za odczyt cache i 15 USD za wyjście. Stawki obejmują całe wywołanie. Opus zachowuje standardowy cennik w całym oknie kontekstu. Przy 280 tys. tokenów wejścia bez cache i 10 tys. rozliczanych tokenów wyjścia przed opłatami za narzędzia wychodzi 1,27 USD dla Sola i 1,32 USD dla Opusa. Przy 100 tys. wejścia koszt spada do 0,30 i 0,60 USD. Kwota 1,27 USD dla długiego promptu jest zbieżna z kosztem Sola Max w indeksie. To dwa osobne obliczenia. Cennik Sola · Specyfikacja Opusa · Cennik Anthropic
Kiedy wysłać zadanie do Opusa
W tygodniowym raporcie z CRM dałbym Solowi stały zestaw rekordów, okres raportowania i krótki format. Każda istotna teza powinna mieć link do źródła. Jeśli brakuje linku, dane są sprzeczne albo człowiek odrzuci szkic, przekaż Opusowi materiały i konkretny błąd do rozwiązania. Gdy rekordu brakuje w źródle, wróć do osoby odpowiedzialnej za dane.
Policz, ile szkiców można zaakceptować bez zmian. Do kosztu dodaj nieudane próby i pracę osoby sprawdzającej. Jeśli droższy model kosztuje o 3 USD więcej i oszczędza pięć minut, sam czas zwraca tę różnicę przy stawce 36 USD za godzinę. Sprawdź, czy ten koszt zwraca się w twoim procesie. To twoje zadania wyznaczają próg. Fable 5.2 vs GPT-6 Astra
Najczęstsze pytania
Czy GPT-6.1 Sol jest tańszy od Claude Opus 5.5?
W standardowym cenniku Sol kosztuje 2 USD za milion tokenów wejścia i 10 USD za milion wyjścia. Opus kosztuje 4 i 20 USD. Powyżej 272 tys. tokenów wejścia Sol podwaja stawki za wejście i cache, a wyjście drożeje o 50%.
Czy ten sam wynik w indeksie oznacza, że modele można stosować zamiennie?
Sol Xhigh i Opus High mają po 52 punkty po zaokrągleniu. W tym zestawieniu Opus prowadzi w Terminal-Bench, a Sol w GDP.pdf.