Claude Fable 5.2 kontra GPT-6 Astra na różnych ustawieniach
Na Max Fable wygrywa 65 do 57. Na Medium ma 56 pkt za 3,80 USD. Sprawdzam koszt, wyniki w kodowaniu i pracę z długimi dokumentami.
GTM Architect & Growth Operator · Insights · 10 listopada 2026 · 6 min czytania
W tym artykule
Anthropic wydał Fable 5.2 9 listopada. Na ustawieniu Max model ma 65 punktów wobec 57 GPT-6 Astra w indeksie Artificial Analysis. Koszt próby to odpowiednio 26,54 i 6,24 USD. Pierwszy test zacząłbym od Fable na Medium. To 56 punktów przy 3,80 USD. Porównanie Artificial Analysis
Ile kosztuje każdy poziom rozumowania
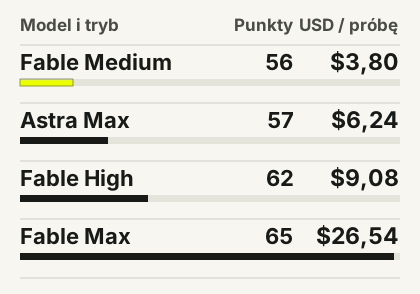
| Model i tryb | Punkty | USD / próbę |
|---|---|---|
| Claude Fable 5.2 Max | 65 | 26,54 USD |
| Claude Fable 5.2 Xhigh | 62 | 14,83 USD |
| Claude Fable 5.2 High | 62 | 9,08 USD |
| GPT-6 Astra Max | 57 | 6,24 USD |
| Claude Fable 5.2 Medium | 56 | 3,80 USD |
| GPT-6 Astra High | 55 | 3,24 USD |
Artificial Analysis podaje ważony koszt API na próbę, wyliczony z użytych tokenów i stawek. Wlicza też próby zakończone niepowodzeniem. Fable badano z domyślnym przełączeniem na model zastępczy. Odczyt z 10 listopada 2026 r. Artificial Analysis Intelligence Index v5.0.1
Fable na Medium traci do Astry Max jeden punkt, a próba kosztuje o 39% mniej. Fable High i Xhigh mają po zaokrągleniu po 62 punkty, przy kosztach 9,08 i 14,83 USD. Najpierw sprawdziłbym High. Do Xhigh przeszedłbym dopiero po sprawdzeniu, w których zadaniach dopłata zmienia wynik. W API Claude domyślny jest High, a w aplikacjach Claude i Claude Code jest to Medium. API Claude · Informacje o premierze
Kod, terminal i dokumenty
| Test Artificial Analysis | Fable 5.2 Max | GPT-6 Astra Max |
|---|---|---|
| FrontierCode 2.0 | 48,8% | 42,4% |
| Terminal-Bench 4.0 | 59,6% | 59,1% |
| GDP.pdf | 24,2% | 31,0% |
| Terminal-Bench-Science 0.1 | 73,3% | 63,3% |
FrontierCode sprawdza zmiany w rzeczywistych repozytoriach open source. Jeśli chcesz ocenić model pod kątem trudnych poprawek, zacznij od tego wyniku. W Terminal-Bench różnica wynosi pół punktu procentowego. W GDP.pdf, który sprawdza odpowiedzi na podstawie długich dokumentów, prowadzi Astra. Wyniki i konfiguracje
Znaczenie ma też środowisko testu. W częściowo niepublicznej części ARC-AGI-3 najlepszy odnotowany wynik w środowisku Standard wyniósł 81,2% dla Fable i 62,7% dla Astry. W środowisku Provider Adapter, które zachowuje stan rozumowania między wywołaniami, wyniki to 97,7% i 99,9%. To najlepsze rezultaty z różnych ustawień w każdym środowisku. Przy wdrożeniu sprawdź konfigurację, która rzeczywiście obsłuży twoje zadania. Fable w ARC Prize · Astra w ARC Prize
Cennik a rachunek za próbę
| Parametr API | Fable 5.2 | GPT-6 Astra |
|---|---|---|
| Wejście / mln tokenów | 8 USD | 10 USD |
| Odczyt cache / mln | 0,20 USD | 1,00 USD |
| Wyjście / mln | 40 USD | 50 USD |
| Okno kontekstu | 1 mln | 1,05 mln |
| Maks. wyjście | 128 tys. | 128 tys. |
| Dopłata za długi prompt | Stawki standardowe do 1 mln | Powyżej 272 tys. tokenów wejścia: 2× wejście i cache, 1,5× wyjście |
Przykładowe wywołanie ze 100 tys. tokenów wejścia bez cache i 10 tys. rozliczanych tokenów wyjścia kosztuje 1,20 USD dla Fable i 1,50 USD dla Astry przed opłatami za narzędzia. W indeksie zużycie tokenów zależy od modelu i ustawień. Stąd inne kwoty w pierwszej tabeli. Specyfikacja Fable · Cennik Anthropic · Specyfikacja Astry
Obie standardowe stawki Fable 5.2 spadły o 20% względem 5.1. Według Anthropic model generuje tokeny do 30% szybciej. Tryb Fast kosztuje 16 USD za milion tokenów wejścia i 80 USD za milion wyjścia. Producent deklaruje do 2,5 raza szybsze generowanie. Przy migracji lub dłuższej analizie zmierz czas od startu do zaakceptowanego wyniku. Ceny i prędkość według Anthropic
Co pokazał eksperyment z Fermatem
Według Anthropic około tysiąca agentów Fable 5.2 sformalizowało dowód wielkiego twierdzenia Fermata w Lean w 30 godzin. Dowód był znany. Praca polegała na zapisaniu go w formie, którą komputer może sprawdzić. Anthropic podaje po jednym przebiegu dla każdego modelu w tym eksperymencie. Opis eksperymentu
Fable i Mythos 5.2 korzystają z tego samego modelu bazowego i cennika. Fable jest dostępny w płatnych planach Claude i w API, z dodatkowymi zabezpieczeniami w zadaniach z cyberbezpieczeństwa i biologii. Bezpośredni dostęp do Mythos wymaga weryfikacji. W CyScenarioBench laboratoria użyły różnych zestawów zadań, więc wyniki z premiery nie rozstrzygają bezpośredniego pojedynku. Premiera i metodologia
Prototyp systemu operacyjnego
W osobnym eksperymencie Fable koordynował według Anthropic ponad tysiąc agentów przez osiem dni. Zbudowali prototyp systemu operacyjnego, który uruchamia się na laptopie. Opis prac
Pierwszy test w repozytorium
Daj Fable Medium i Astrze Max tę samą trudną zmianę. Ustal jeden commit startowy, te same testy, narzędzia i limit czasu. Osoba sprawdzająca kod powinna dostać poprawki bez informacji, który model je przygotował. Zapisz wynik testów, czas przeglądu i koszt wszystkich prób. Przejdź na Fable High, jeśli dodatkowe rozumowanie może pomóc w przypadkach, w których Medium się wykłada.
Do zwykłych zgłoszeń włączyłbym też do testu Opusa 5.5 albo GPT-6.1 Sol. Jeśli wybierasz narzędzie do uruchamiania modeli, zobacz osobne porównanie wraz z testowanymi wersjami. Claude Code vs Codex po angielsku · GPT-6.1 Sol vs Claude Opus 5.5
Najczęstsze pytania
Czy Claude Fable 5.2 jest lepszy od GPT-6 Astra?
Na Max Fable prowadzi 65 do 57 w Artificial Analysis Intelligence Index v5.0.1. W tym zestawieniu wygrywa w FrontierCode 2.0, a Astra ma lepszy wynik w GDP.pdf.
Czy Claude Fable 5.2 jest tańszy od GPT-6 Astra?
Fable ma niższą cenę tokenów wejściowych i wyjściowych. Na Max koszt próby w indeksie to 26,54 USD dla Fable i 6,24 USD dla Astry. Na Medium Fable kosztuje 3,80 USD.
Czym różni się Fable 5.2 od Mythos 5.2?
To ten sam model bazowy i cennik. Fable ma dodatkowe zabezpieczenia w cyberbezpieczeństwie i biologii. Bezpośredni dostęp do Mythos wymaga weryfikacji przez Anthropic.