Claude Fable 5.2 frente a GPT-6 Astra según el nivel de razonamiento
Fable gana 65 a 57 en Max. En Medium obtiene 56 puntos por 3,80 USD. Compara el coste, la programación y el trabajo con documentos largos.
GTM Architect & Growth Operator · Insights · 10 de noviembre de 2026 · 6 min de lectura
En esta página
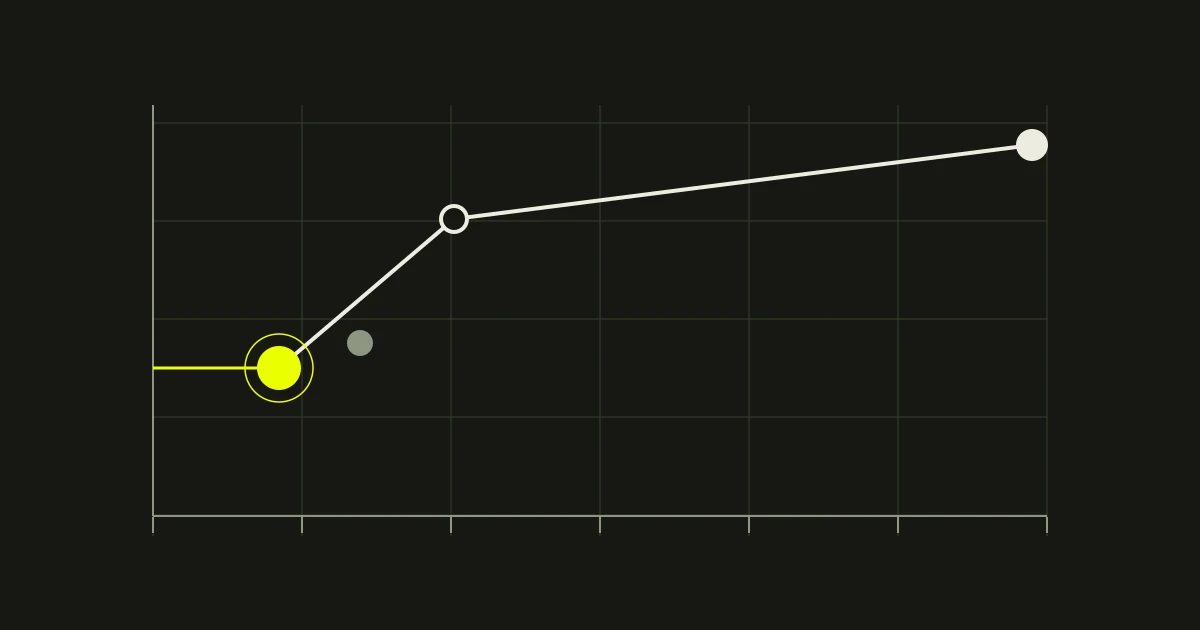
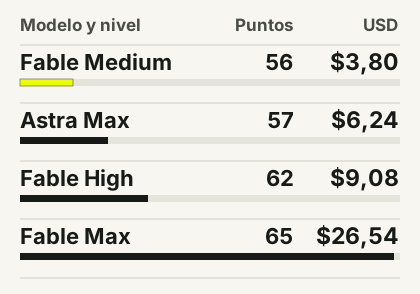
Anthropic lanzó Fable 5.2 el 9 de noviembre. Con el ajuste Max obtiene 65 puntos frente a 57 de GPT-6 Astra en Artificial Analysis. Cada intento cuesta 26,54 y 6,24 USD, respectivamente. Para una primera prueba elegiría Fable en Medium, con 56 puntos por 3,80 USD. Comparativa de Artificial Analysis
Qué cuesta cada nivel de razonamiento
| Modelo y nivel | Puntos | USD / intento |
|---|---|---|
| Claude Fable 5.2 Max | 65 | 26,54 USD |
| Claude Fable 5.2 Xhigh | 62 | 14,83 USD |
| Claude Fable 5.2 High | 62 | 9,08 USD |
| GPT-6 Astra Max | 57 | 6,24 USD |
| Claude Fable 5.2 Medium | 56 | 3,80 USD |
| GPT-6 Astra High | 55 | 3,24 USD |
Artificial Analysis estima el coste medio ponderado de API por intento a partir de los tokens consumidos y las tarifas. La cifra incluye los intentos fallidos. Las pruebas de Fable usan la configuración predeterminada del modelo de respaldo. Datos consultados el 10 de noviembre de 2026. Intelligence Index v5.0.1 de Artificial Analysis
Fable en Medium queda a un punto de Astra Max con un coste un 39% menor por intento. En High y Xhigh, Fable redondea a 62 puntos en ambos casos, por 9,08 y 14,83 USD. Probaría primero High y subiría a Xhigh si el tipo de tarea justifica la diferencia. High es el ajuste predeterminado en la API de Claude. En las aplicaciones Claude y en Claude Code es Medium. API de Claude · Detalles del lanzamiento
Código, terminal y documentos
| Prueba de Artificial Analysis | Fable 5.2 Max | GPT-6 Astra Max |
|---|---|---|
| FrontierCode 2.0 | 48,8 % | 42,4 % |
| Terminal-Bench 4.0 | 59,6 % | 59,1 % |
| GDP.pdf | 24,2 % | 31,0 % |
| Terminal-Bench-Science 0.1 | 73,3 % | 63,3 % |
FrontierCode evalúa cambios en repositorios reales de código abierto. Ese resultado sirve para elegir qué modelos poner a prueba con una corrección difícil. En Terminal-Bench los separa medio punto porcentual. Astra aventaja a Fable en GDP.pdf, una prueba que exige responder a partir de documentos largos. Resultados y configuraciones
El entorno de evaluación puede cambiar la clasificación. En los juegos semiprivados de ARC-AGI-3, los mejores resultados en el entorno Standard fueron 81,2% para Fable y 62,7% para Astra. Con Provider Adapter, que conserva el estado del razonamiento entre peticiones, obtuvieron 97,7% y 99,9%. Son los mejores resultados observados entre varios ajustes en cada entorno. Si vas a desplegar un agente, prueba la configuración que usará para trabajar. Fable en ARC Prize · Astra en ARC Prize
La tarifa y el coste de cada intento
| Parámetro de API | Fable 5.2 | GPT-6 Astra |
|---|---|---|
| Entrada / millón de tokens | 8 USD | 10 USD |
| Lectura de caché / millón | 0,20 USD | 1,00 USD |
| Salida / millón | 40 USD | 50 USD |
| Ventana de contexto | 1 millón | 1,05 millones |
| Salida máxima | 128 mil | 128 mil |
| Recargo por contexto largo | Tarifa estándar hasta 1 millón | Por encima de 272 mil tokens de entrada: 2× entrada y caché, 1,5× salida |
Una petición de ejemplo con 100 mil tokens de entrada sin caché y 10 mil tokens de salida facturables cuesta 1,20 USD en Fable y 1,50 USD en Astra, antes de las herramientas. En el índice, el consumo de tokens varía según el modelo y el ajuste. De ahí las cifras de la primera tabla. Especificaciones de Fable · Tarifas de Anthropic · Especificaciones de Astra
Las tarifas estándar de entrada y salida de Fable 5.2 bajaron un 20% con respecto a Fable 5.1. Anthropic indica que genera tokens hasta un 30% más rápido. El modo Fast cuesta 16 USD por millón de tokens de entrada y 80 USD por millón de salida. Según el proveedor, la generación puede ser hasta 2,5 veces más rápida. En una migración o una investigación larga, mide el tiempo hasta que alguien pueda dar el trabajo por bueno. Tarifas y velocidad según Anthropic
Qué mostró el experimento con el teorema de Fermat
Anthropic afirma que unos mil agentes de Fable 5.2 formalizaron en Lean la demostración del último teorema de Fermat en 30 horas. La demostración ya existía. La tarea consistía en expresarla de forma que un ordenador pudiera verificarla. Anthropic describe una ejecución por modelo en ese experimento. Descripción del experimento
Fable y Mythos 5.2 comparten modelo base y tarifa. Fable está disponible en planes de pago de Claude y en la API, con protecciones adicionales para ciberseguridad y biología. El acceso directo a Mythos pasa por los programas de verificación de Anthropic. Los laboratorios usaron tareas distintas en CyScenarioBench, así que las cifras del lanzamiento no resuelven una comparación directa. Lanzamiento y metodología
Prototipo de sistema operativo
En un experimento de programación separado, Anthropic afirma que Fable coordinó a más de mil agentes durante ocho días para construir un prototipo de sistema operativo capaz de arrancar en un portátil. Descripción técnica
Primera prueba en tu repositorio
Da a Fable Medium y Astra Max el mismo cambio difícil. Usa el mismo commit de partida, las mismas pruebas y herramientas y el mismo límite de tiempo. Pide que se revisen los cambios sin saber qué modelo los escribió. Registra qué cambios pasan las pruebas, cuánto tiempo lleva revisarlos y lo que cuestan todos los intentos. Prueba Fable High si los fallos de Medium parecen resolverse con más razonamiento.
Para los tickets habituales, también incluiría a Opus 5.5 o GPT-6.1 Sol. Las herramientas que ejecutan los modelos merecen su propia evaluación. Claude Code frente a Codex en inglés · GPT-6.1 Sol frente a Claude Opus 5.5
Preguntas frecuentes
¿Claude Fable 5.2 es mejor que GPT-6 Astra?
Fable gana 65 a 57 en Max en el Intelligence Index v5.0.1 de Artificial Analysis. En esa comparativa se impone en FrontierCode 2.0 y Astra gana en GDP.pdf.
¿Claude Fable 5.2 es más barato que GPT-6 Astra?
Los tokens de entrada y salida de Fable tienen un precio estándar menor. En Max cuesta 26,54 USD por intento en el índice, frente a 6,24 USD de Astra. En Medium, Fable cuesta 3,80 USD.
¿Qué diferencia hay entre Fable 5.2 y Mythos 5.2?
Comparten el modelo base y la tarifa. Fable incorpora protecciones adicionales para ciberseguridad y biología. Para acceder directamente a Mythos, Anthropic exige una verificación.