Claude Fable 5.2 und GPT-6 Astra nach Reasoning-Stufe im Vergleich
Fable gewinnt auf Max mit 65 zu 57 Punkten. Auf Medium erreicht es 56 für 3,80 USD. Der Vergleich zeigt Kosten, Coding und lange Dokumente.
GTM Architect & Growth Operator · Insights · 10. November 2026 · 6 Min. Lesezeit
Auf dieser Seite
Anthropic hat Fable 5.2 am 9. November veröffentlicht. Auf Max erreicht Fable bei Artificial Analysis 65 Punkte, GPT-6 Astra 57. Ein Versuch kostet 26,54 USD bei Fable und 6,24 USD bei Astra. Für einen ersten Test würde ich Fable auf Medium setzen. Damit erreicht es 56 Punkte für 3,80 USD. Vergleich von Artificial Analysis
Kosten nach Reasoning-Stufe
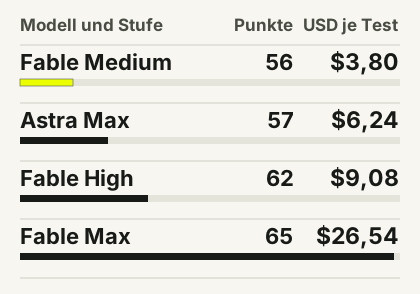
| Modell und Stufe | Punkte | USD je Versuch |
|---|---|---|
| Claude Fable 5.2 Max | 65 | 26,54 USD |
| Claude Fable 5.2 Xhigh | 62 | 14,83 USD |
| Claude Fable 5.2 High | 62 | 9,08 USD |
| GPT-6 Astra Max | 57 | 6,24 USD |
| Claude Fable 5.2 Medium | 56 | 3,80 USD |
| GPT-6 Astra High | 55 | 3,24 USD |
Artificial Analysis schätzt die gewichteten API-Kosten je Versuch anhand der genutzten Token und der Tarife. Fehlgeschlagene Versuche fließen ein. Fable wurde mit der Standardeinstellung für das Ausweichmodell getestet. Stand 10. November 2026. Intelligence Index v5.0.1 von Artificial Analysis
Fable Medium liegt einen Punkt hinter Astra Max und kostet je Versuch 39 % weniger. Auf High und Xhigh erreicht Fable gerundet jeweils 62 Punkte für 9,08 und 14,83 USD. Ich würde zuerst High testen und Xhigh erst einsetzen, wenn sich der Aufpreis bei den eigenen Aufgaben auszahlt. In der Claude API ist High voreingestellt. In den Claude-Apps und in Claude Code ist es Medium. Claude API · Details zur Veröffentlichung
Code, Terminal und Dokumente
| Test von Artificial Analysis | Fable 5.2 Max | GPT-6 Astra Max |
|---|---|---|
| FrontierCode 2.0 | 48,8 % | 42,4 % |
| Terminal-Bench 4.0 | 59,6 % | 59,1 % |
| GDP.pdf | 24,2 % | 31,0 % |
| Terminal-Bench-Science 0.1 | 73,3 % | 63,3 % |
FrontierCode bewertet Änderungen an echten Open-Source-Repositories. Wenn Sie einen schwierigen Patch testen wollen, ist dieser Benchmark ein guter Ausgangspunkt. In Terminal-Bench beträgt der Abstand nur einen halben Prozentpunkt. Bei GDP.pdf, wo es um Antworten auf Basis langer Dokumente geht, liegt Astra vorn. Testergebnisse und Einstellungen
Auch die Testumgebung kann die Reihenfolge ändern. In den teilweise nicht öffentlichen Spielen von ARC-AGI-3 erreichte Fable in der Standardumgebung im besten Fall 81,2 %, Astra 62,7 %. Mit Provider Adapter, der den Reasoning-Zustand zwischen Anfragen erhält, waren es 97,7 % und 99,9 %. Das sind die besten beobachteten Ergebnisse über mehrere Einstellungen pro Umgebung. Testen Sie deshalb auch die Konfiguration, in der Ihr Agent später arbeitet. Fable bei ARC Prize · Astra bei ARC Prize
Listenpreise und tatsächlicher Verbrauch
| API-Merkmal | Fable 5.2 | GPT-6 Astra |
|---|---|---|
| Eingabe je Mio. Token | 8 USD | 10 USD |
| Cache-Lesezugriff je Mio. | 0,20 USD | 1,00 USD |
| Ausgabe je Mio. | 40 USD | 50 USD |
| Kontextfenster | 1 Mio. | 1,05 Mio. |
| Maximale Ausgabe | 128.000 | 128.000 |
| Aufpreis für lange Prompts | Standardtarif bis 1 Mio. | Über 272.000 Eingabetoken: 2× Eingabe und Cache, 1,5× Ausgabe |
Eine Beispielanfrage mit 100.000 nicht gecachten Eingabetoken und 10.000 abrechenbaren Ausgabetoken kostet ohne Tools 1,20 USD bei Fable und 1,50 USD bei Astra. Im Index verbrauchen die Modelle je nach Einstellung unterschiedlich viele Token. Deshalb stehen in der ersten Tabelle andere Beträge. Fable-Spezifikation · Anthropic-Preise · Astra-Spezifikation
Die Standardpreise von Fable 5.2 für Eingabe und Ausgabe liegen 20 % unter denen von Fable 5.1. Laut Anthropic erzeugt das Modell Token bis zu 30 % schneller. Der Fast-Modus kostet 16 USD je Million Eingabetoken und 80 USD je Million Ausgabetoken. Anthropic gibt eine bis zu 2,5-fache Generierungsgeschwindigkeit an. Bei einer Migration oder längeren Analyse würde ich die Zeit bis zu einem freigegebenen Ergebnis messen. Preise und Geschwindigkeitsangaben von Anthropic
Was das Fermat-Experiment gezeigt hat
Laut Anthropic haben rund tausend Fable-5.2-Agenten den Beweis von Fermats letztem Satz in 30 Stunden in Lean formalisiert. Der Beweis lag bereits vor. Die Aufgabe bestand darin, ihn so auszudrücken, dass ein Computer ihn prüfen kann. Anthropic beschreibt für dieses Experiment einen Durchlauf pro Modell. Beschreibung des Experiments
Fable und Mythos 5.2 nutzen dasselbe Basismodell und haben denselben Listenpreis. Fable ist in den kostenpflichtigen Claude-Tarifen und in der API verfügbar. Es enthält zusätzliche Schutzmaßnahmen für Aufgaben aus Cybersicherheit und Biologie. Direkter Mythos-Zugriff läuft über Anthropics Prüfprogramme. Bei CyScenarioBench haben die Labore unterschiedliche Aufgaben verwendet. Die veröffentlichten Werte erlauben daher keinen direkten Modellvergleich. Veröffentlichung und Methodik
Prototyp eines Betriebssystems
In einem eigenen Coding-Experiment koordinierte Fable laut Anthropic über tausend Agenten über acht Tage. Sie entwickelten einen Betriebssystem-Prototyp, der auf einem Laptop startet. Beschreibung des Coding-Experiments
Der erste Test im eigenen Repository
Geben Sie Fable Medium und Astra Max dieselbe schwierige Änderung. Legen Sie den Ausgangs-Commit, die Tests, die Werkzeuge und das Zeitlimit fest. Die Person im Review sollte das Modell hinter dem jeweiligen Patch nicht kennen. Erfassen Sie Testergebnis, Prüfzeit und die Kosten aller Versuche. Testen Sie Fable High, wenn mehr Reasoning bei den Fehlern von Medium helfen dürfte.
Für Routine-Tickets würde ich Opus 5.5 oder GPT-6.1 Sol dazunehmen. Für die Wahl der Entwicklungsumgebung gibt es einen eigenen Vergleich mit den jeweils getesteten Modellen. Claude Code und Codex im Vergleich auf Englisch · GPT-6.1 Sol und Claude Opus 5.5
Häufige Fragen
Ist Claude Fable 5.2 besser als GPT-6 Astra?
Auf Max führt Fable im Intelligence Index v5.0.1 von Artificial Analysis mit 65 zu 57 Punkten. Fable gewinnt in diesem Vergleich bei FrontierCode 2.0. Bei GDP.pdf liegt Astra vorn.
Ist Claude Fable 5.2 günstiger als GPT-6 Astra?
Fable hat niedrigere Standardpreise für Eingabe und Ausgabe. Auf Max kostet ein Versuch im Index 26,54 USD für Fable und 6,24 USD für Astra. Auf Medium kostet Fable 3,80 USD.
Was unterscheidet Fable 5.2 von Mythos 5.2?
Beide nutzen dasselbe Basismodell zum selben Listenpreis. Fable hat zusätzliche Schutzmaßnahmen für Cybersicherheit und Biologie. Direkter Zugriff auf Mythos setzt eine Prüfung durch Anthropic voraus.